AIエージェントのセキュリティを徹底解説!リスクと企業の対策も紹介
調べものや定型作業をAIエージェントに任せる動きが、部門単位で広がっています。便利さは分かる一方で、情報漏えいや誤操作の報道を見ると、このまま承認してよいのか判断に迷うのではないでしょうか。
AIエージェントのセキュリティは、従来の「読んで答えるAI」への対策とは別物です。この記事では、何が新しいリスクなのか・実際に起きた事件・企業がとるべき対策と承認前の確認点を、公的機関とベンダーの一次情報に基づいて解説します。
記事を読めば、自社で任せてよい範囲と条件を自分の言葉で説明できるようになります。結論から言うと、危険は「機密データへのアクセス」「外部の信頼できない情報」「実行権限」の3つが重なる場所で生まれ、対策の本質はこの重なりを設計で減らすことです。
AIエージェントのセキュリティは何が新しいのか
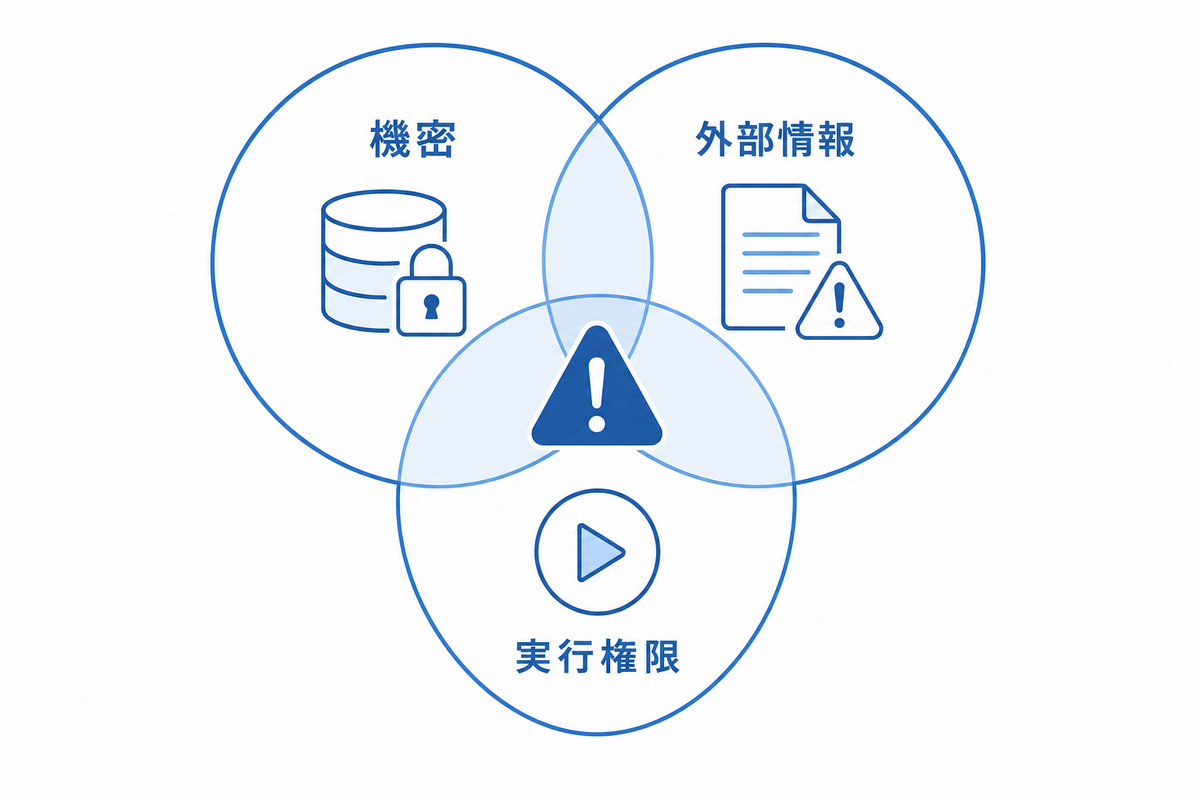
まず前提を以下の3つで押さえます。
- 「読むAI」から「実行するAI」への変化がリスクの質を変えた
- 危険は3つの要素が重なる場所で生まれる
- 公的機関も新しい脅威として扱い始めている
「読むAI」から「実行するAI」への変化がリスクの質を変えた
チャット型の生成AIは、質問に答えを返すまでが仕事でした。AIエージェントは、ファイルの読み書き・メールやWebの参照・システムの操作といった「実行」まで自律的に進めます。
実行する主体になったことで、だまされたときの被害が「間違った答え」から「間違った行動」へ変わりました。誤った送信・データの削除・権限の悪用など、被害が現実の業務へ直接届く点が新しさです。
危険は3つの要素が重なる場所で生まれる
AIエージェントの事故は、次の3つがそろった場所で起きます。
- 機密データへのアクセス(顧客情報・社内文書・認証情報)
- 外部の信頼できない情報への接触(Webページ・受信メール・添付ファイル)
- 実行権限(送信・書き換え・削除・購入などの操作)
外部の情報の中に紛れ込ませた指示でAIを操る攻撃をプロンプトインジェクションと呼びます。3つがそろうと、外から来た偽の指示が、機密データを持つ実行者を動かせる構図です。逆に言えば、どれか1つを設計で外せば被害の芽は大きく減ります。
公的機関も新しい脅威として扱い始めている
IPA(情報処理推進機構)が毎年公表する「情報セキュリティ10大脅威」の2026年版では、組織向けの3位に「AIの利用をめぐるサイバーリスク」が初めて選出されました。AIの業務利用が、専門家の間でも主要な脅威として並んだ形です。
総務省・経済産業省の「AI事業者ガイドライン」も、2026年3月の第1.2版でAIエージェントの用語を正式に取り込みました。「様子見の新技術」ではなく、公的な管理対象になったと捉えるのが正確です。
実際に起きた事件【一次発表があるもの3つ】
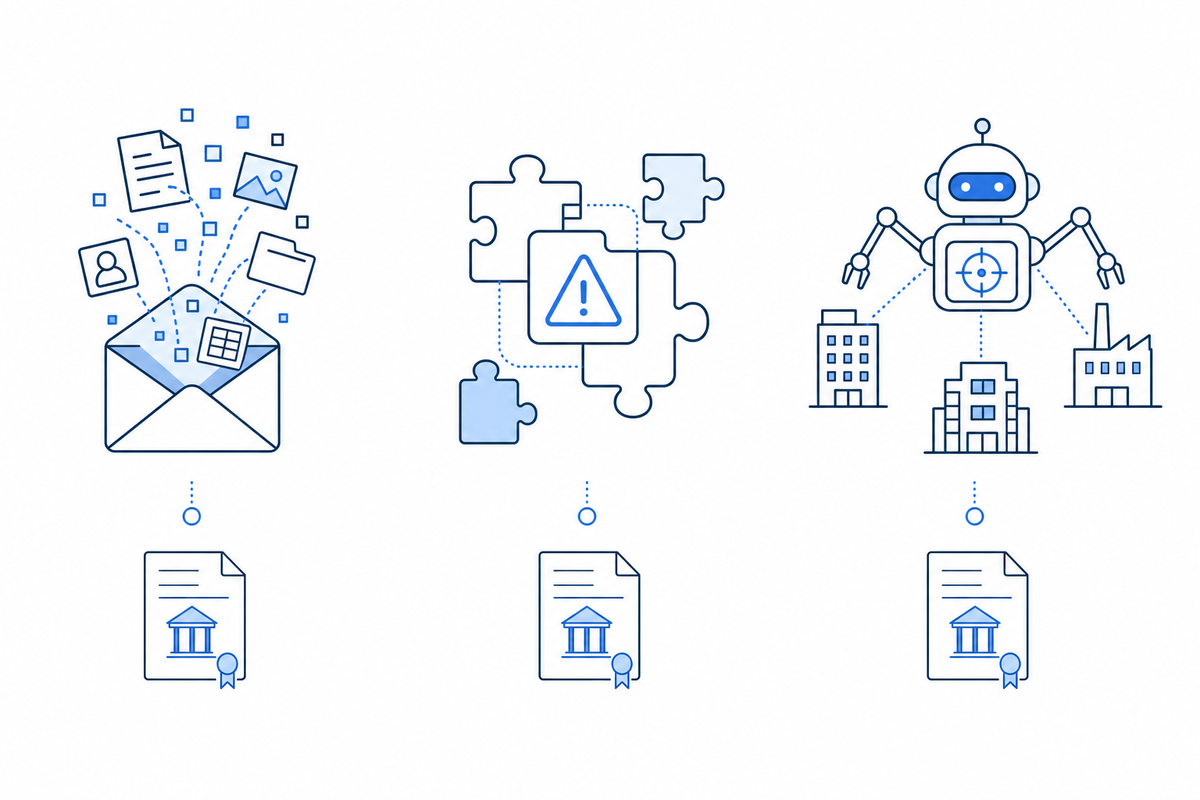
危険は仮定の話ではありません。当事者や公的機関の一次発表がある事件を3つ紹介します。
- メールを開かせるだけでAI経由の情報漏えいにつながる欠陥
- 開発支援AIへの不正な指示コードの混入
- 攻撃の大半をAIが実行したサイバー諜報活動
メールを開かせるだけでAI経由の情報漏えいにつながる欠陥
2025年6月、Microsoft 365のAIアシスタントに「EchoLeak」と呼ばれる欠陥が公表されました(CVE-2025-32711)。細工したメールを送るだけで、受け取った側のAIが内部の情報を外部へ漏らしうる、利用者の操作を必要としない型の欠陥です。
深刻度の評価は、米国の脆弱性データベース(NVD)で7.5、Microsoft自身の評価で9.3とされました。修正済みですが、「AIに読ませる情報の経路そのものが攻撃口になる」ことを示した代表例です。
開発支援AIへの不正な指示コードの混入
2025年7月、AWSはコード支援AI「Amazon Q」の拡張機能に、データ消去を指示する不正なコードが混入したと公表しました(AWS-2025-015)。コードは構文の誤りで実行されず、実害はなかったとAWSは説明しています。
注目すべきは、攻撃の狙いが「AIそのもの」ではなく「AIに渡る指示の流通経路」だった点です。配布物や拡張機能の出所管理が、AI時代のサプライチェーン対策になります。
攻撃の大半をAIが実行したサイバー諜報活動
2025年11月、Anthropicは、国家支援の攻撃グループがClaude Codeを悪用した諜報活動を検知・遮断したと発表しました。約30の組織が標的になり、攻撃作業の8〜9割をAIが実行し、人間の介入は要所の数回だけだったとされています。
攻撃側もエージェントを使う時代が、当事者の一次発表で確認された形です。守る側だけが手作業のままでは釣り合いが取れない前提で対策を考える必要があります。
AIエージェント特有のリスクの整理【4つの型】
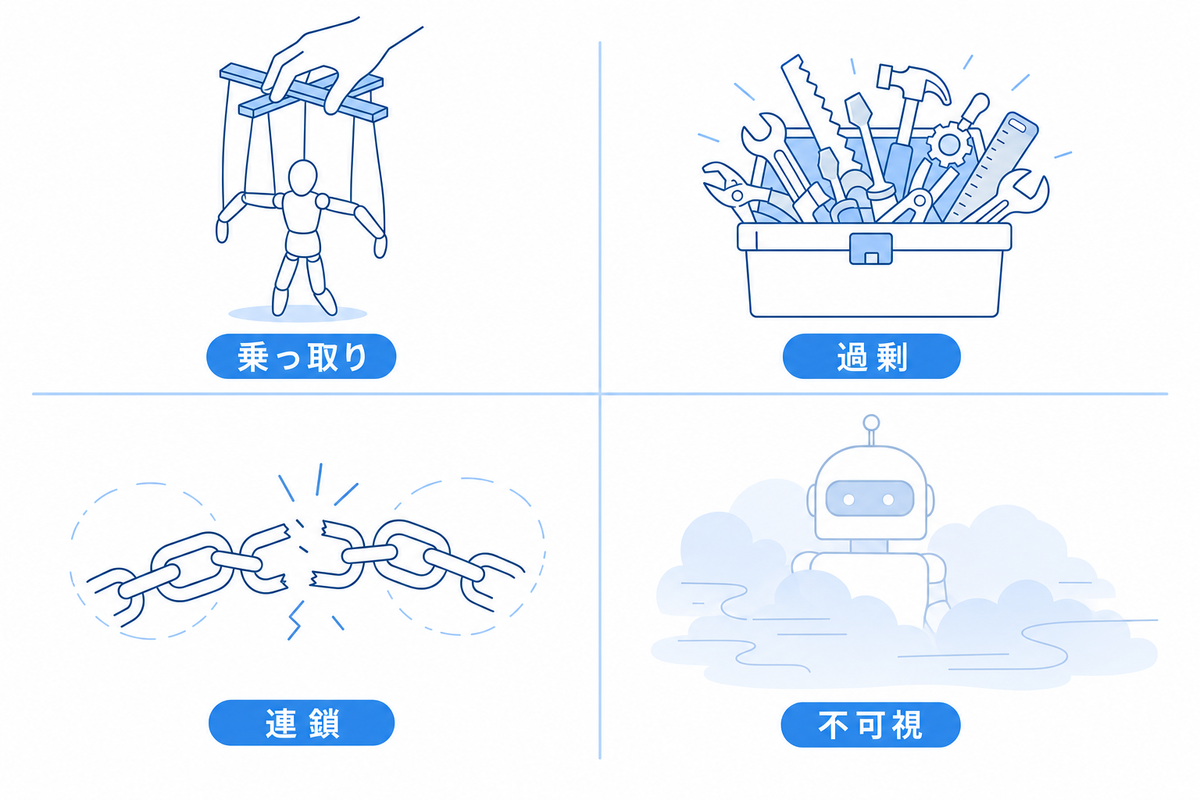
国際的なセキュリティ団体OWASPは、2026年版のエージェント特有リスク上位10項目を公表しています。意思決定者向けには、以下の4つの型に翻訳すると全体がつかめます。
- 乗っ取られる(目的や指示のすり替え)
- やりすぎる(権限と道具の使いすぎ)
- つながった先から壊れる(部品と連携の汚染)
- 見えなくなる(無断利用と記録の欠如)
乗っ取られる(目的や指示のすり替え)
読ませた文書やWebページに仕込まれた偽の指示で、エージェントの目的がすり替えられる型です。プロンプトインジェクションはこの型の代表になります。
対策の起点は、信頼できない情報源との接点を洗い出すことです。「どこから来た文章を読ませるか」を管理する発想が、従来のウイルス対策にはなかった新しい観点になります。
やりすぎる(権限と道具の使いすぎ)
本来の業務に不要な権限まで持たされたエージェントが、だまされたときや誤動作のときに大きな被害を出す型です。人間の従業員なら当然行う「役割に応じた権限の絞り込み」が、AIには未整備のまま運用されがちです。
送信・削除・購入のような取り返しのつかない操作には、人間の承認を挟む設計が基本になります。
つながった先から壊れる(部品と連携の汚染)
エージェントは、外部ツールとの接続や拡張機能の組み合わせで動きます。その部品のどれかが汚染されると、全体が汚染される型です。Amazon Qの事件はこの型の実例にあたります。
接続するツールや拡張機能を「信頼できる出所だけ」に絞る管理が対策の中心です。便利な個人配布の部品を無審査で足す運用は、この型のリスクを直接広げます。
見えなくなる(無断利用と記録の欠如)
会社が把握しないまま、現場が個人契約のAIエージェントを業務に使う型です。何を読ませ、何を実行させたかの記録が残らず、事故が起きても原因をたどれません。
禁止だけでは地下に潜るため、公式に使える環境と記録の仕組みを用意する方が実効的です。この論点はシャドーAIの記事で詳しく解説しています。
シャドーAIとは?リスクと対策を徹底解説!公認ルートの作り方も紹介
企業がとるべき対策の3原則
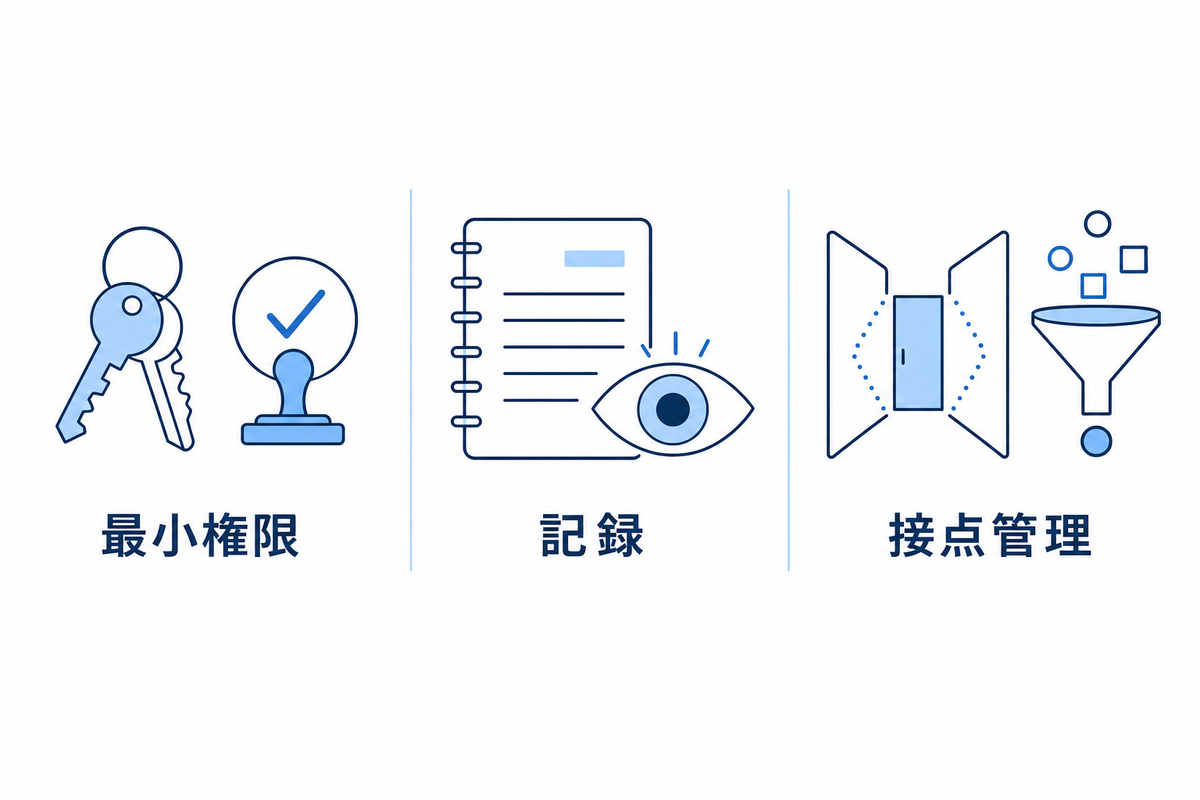
対策は数多くありますが、原則は以下の3つに集約されます。
- 権限は最小限にして危険な操作に承認を挟む
- 記録を残して全体を見えるようにする
- 信頼できない情報との接点を設計で絞る
権限は最小限にして危険な操作に承認を挟む
エージェントには、その業務に必要な最小限の権限だけを与えます。読み取りだけで足りる業務に書き換えの権限を持たせない、が基本形です。
そのうえで、削除・外部送信・支払いのような影響の大きい操作は、実行前に人間の承認を必須にします。主要なAIエージェント製品には承認や権限の設定が標準で備わっているため、まず既定の安全設定を切らずに使うことが第一歩です。
Claude Codeの権限設定を徹底解説!自動承認を安全に使う方法も紹介
記録を残して全体を見えるようにする
誰がどのエージェントに何をさせたかの記録(ログ)を残し、後から確認できる状態を保ちます。記録は事故対応のためだけでなく、「見られている」こと自体が誤用の抑止になります。
あわせて、社内で動いているAIエージェントの棚卸しを定期的に行ってください。把握していないエージェントは、対策の対象にすら入りません。
信頼できない情報との接点を設計で絞る
エージェントに読ませる情報源を、業務に必要な範囲へ絞ります。外部のWebページや受信メールを自由に読ませる設計は、偽の指示の入口を開けたままにする設計と同じです。
接点をゼロにできない業務では、読み取り専用の役割に分ける方法や、外部を読む担当と実行する担当を分ける方法が有効になります。生成AI全般の基礎対策は、次の記事にまとめています。
生成AIのセキュリティを徹底解説!リスクの分類と会社でやるべき対策も紹介
導入を承認する前に確認すべき4つの質問
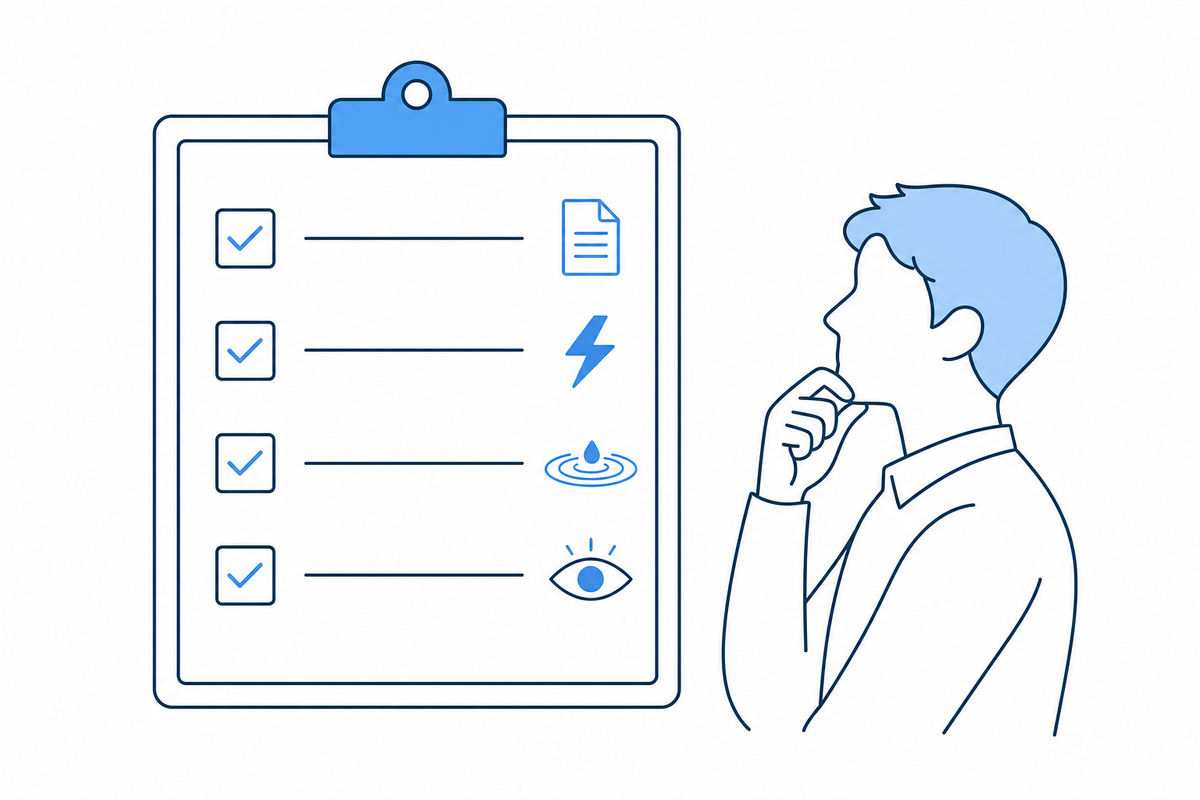
Anthropicが公開している経営層向けの指針では、エージェント導入の承認前に次の4つを確認するよう勧めています。
1. そのエージェントは、信頼できない外部の情報を読みますか
2. そのエージェントは、何を実行できますか
3. 誤動作したとき、影響はどこまで広がりますか
4. 行動を記録し、あとから確認できますか
4つの質問は、危険の3要素(機密アクセス・外部情報・実行権限)と記録の有無を、承認の場で確かめるための言い換えです。Anthropicの指針は質問の先の具体策として、接続先の許可リスト化や全社での緊急停止手段の用意を含む7つの統制も挙げています。細かさは自社の規模に合わせれば十分です。ベンダーや推進部門への質問リストとして、このまま使えます。
回答があいまいな項目が残るうちは、その項目に触れない範囲(読み取り専用・社内データのみ等)で試験導入する、が安全側の判断です。
AIエージェントのセキュリティに関するよくある質問
導入判断で残りやすい疑問へ、3つ回答します。
- 対策すれば100%安全になりますか?
- まず何から始めるべきですか?
- 生成AIのセキュリティ対策と何が違いますか?
対策すれば100%安全になりますか?
なりません。Anthropicは自社のブラウザ操作エージェントについて、対策によって指示混入攻撃の成功率を23.6%から11.2%へ下げたと公表しています。ベンダー自身が「下げられるがゼロではない」と数字で示している状態です。
だからこそ、攻撃を前提に権限を絞り、危険な操作に承認を挟んで記録を残す多層の設計が要ります。「完全に安全なツール」を探すのではなく、事故の影響を小さくする体制を作るのが正しい目標です。
まず何から始めるべきですか?
最初の一歩は、社内で使われているAIエージェントの棚卸しです。対象が見えなければ、どの対策も始まりません。
棚卸しでは、使っているAIツールの名前・用途・読ませているデータ・実行させている操作の4点を部門ごとに一覧へまとめます。この一覧がそのまま対策の優先順位表です。次に、読み取り専用・社内データのみの低リスク業務から公式に許可し、権限と記録の型を作ってから範囲を広げます。禁止から入るより、安全な公式ルートを先に用意する方が、無断利用の抑止まで含めて効果的です。
生成AIのセキュリティ対策と何が違いますか?
入力情報の管理や機密の扱いといった基礎は共通です。違いは、「行動するAI」ならではの実行権限の管理・危険な操作への承認・行動記録の3点が加わることです。
チャット型AIのルールを整備済みの会社でも、エージェント導入時にはこの3点の追記が必要になります。既存ルールの延長で流用すると、実行まわりの穴が残ります。
AIエージェントのセキュリティは「重なり」を設計で減らせば管理できます
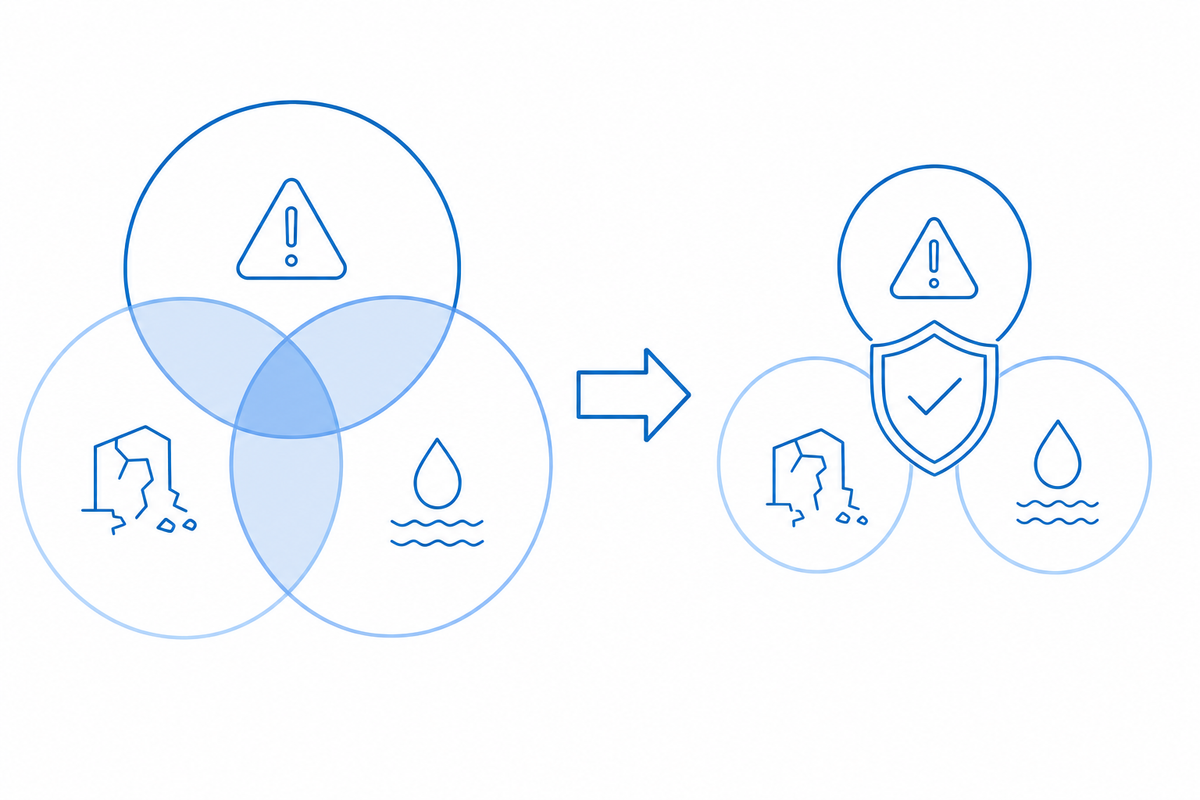
AIエージェントのセキュリティリスクは、機密データへのアクセス・外部の信頼できない情報・実行権限の3つが重なる場所で生まれます。実際の事件はいずれもこの構図で起きており、対策の本質は権限の最小化・承認・記録・接点の設計で重なりを減らすことです。
導入を止める必要はありません。まずは社内のAI利用の棚卸しと、承認前の4つの質問から始めて、任せてよい範囲を自社の言葉で線引きしましょう。